第 2.13 章|从 GPU 到 AI 工厂
一颗更快的 GPU 只有在内存、网络、电力、冷却和数据中心同时到位时才产生价值。比较下一代平台时,既要看芯片性能,也要看系统总支出向哪些环节迁移。

GPU 为什么不是正确的投资核算单位
如果只拆一颗加速器,Blackwell Ultra 与 Vera Rubin 的差异看起来主要是制程、内存和带宽;如果把镜头拉到机架,交换芯片、主机内存、网卡、电源和液冷开始决定更多价值;继续拉到 100 MW 园区,变电站、开关设备、冷却装置、建筑和持续电费又形成第二张 BOM。
这三个边界不能混用。加速器封装回答芯片里有什么;完整系统回答客户为可运行计算还要购买什么;100 MW 已投运 IT 铭牌容量设施回答这些系统需要什么物理环境。机架价格不是设施价格,160 柜 SuperPoD 也不能在没有统一功率分母时与单机架 NVL72 直接比较。
本章用四套锚定系统——Blackwell Ultra、Vera Rubin、Ascend 910C 和 Ascend 950DT——追踪同一笔资本如何从芯片流向机架和园区。重点不是制造一个总分,而是找出下一代增加了哪些内容、哪些供应商可能获得收入,以及哪些关系仍停留在路线图。
四套系统揭示了三种不同的价值迁移
美国平台在 GPU 数量不变时继续提高系统内容。 GB300 NVL72 与 Vera Rubin NVL72 都包含 72 个 GPU、36 个 CPU,并提供 20.736 TB GPU 内存。Rubin 把机架 HBM 带宽从 576 提升至约 1,580 TB/s,把 NVLink 带宽从 130 提升至 260 TB/s,并把单 GPU 横向扩展带宽从 0.8 提升至 1.6 Tb/s;CPU 内存也从 17.28 增至 54 TB。增长因而更多落到 HBM4、主机内存、交换、网络和电能质量,而不是 GPU 颗数。
中国平台用更大系统弥补单点能力。 已部署的 Atlas 900 A3 是 16 柜、384 个 Ascend 910C 的系统。华为在 2026 年 7 月 17 日展示了 1,024 卡 Atlas 950 实体配置,另行披露的路线图上限是 160 柜、8,192 卡,目标为 2026 年第四季度。演示配置与路线图最大配置不是同一产品状态,更不能表述成“当前已出货 8,192 卡”。
设施经济学正在变成平台比较的闸门。 NVIDIA 为 GB300 NVL72 标示最高 142 kW;若一座 100 MW IT 铭牌容量设施把 80 MW 分配给计算,可容纳约 563 个机架,计算占比在 70%–88% 时对应 493–620 个机架。Rubin、Atlas 900 A3 与 Atlas 950 没有披露完整系统功率,因此不能诚实换算同一设施能部署多少套。这里的“无法计算”不是缺陷,而是防止虚假可比性的必要结论。
设施本身也不是尾数。模型估算的 100 MW 设施侧已安装资本开支,美国为 11.18 亿—18.14 亿美元,中国为 6.61 亿—11.74 亿美元,基准情景分别为 13.72 亿与 8.95 亿美元。共同采用 1.25 PUE、65% 利用率时,每座设施年耗电约 711.75 GWh。这些是全国性情景,不是项目报价,也不能证明某个具名设备商服务于某个平台。
怎样阅读一张 AI 工厂 BOM
BOM 是 bill of materials 的缩写,直译是物料清单。它回答的是:为了交付一个可以工作的系统,客户还必须购买哪些部件和服务。一颗 GPU 只是 AI 工厂的一部分,系统还需要内存、CPU、网络、电源、冷却、机房和电网;供应商名单只有放进这套交付边界,才具有可比较的经济含义。
本章同时展示三张 BOM,是因为每一张回答的投资问题不同。
| 核算边界 | 最接近日常世界的类比 | 主要回答什么 | 不能回答什么 |
|---|---|---|---|
| 加速器封装 | 一台发动机 | GPU、HBM、基板与封装里增加了什么 | 一套系统能否稳定运行 |
| 机架或 SuperPoD | 一辆可驾驶的整车 | 客户为了获得计算还要买多少 CPU、网络、电源和冷却 | 园区总建设成本与可容纳数量 |
| 100 MW IT 设施 | 道路、车库、加油与维修体系 | 交付这些系统需要多少供配电、冷却、建筑和持续电费 | 某家供应商一定能获得多少收入 |
边界越往外,数字越大,也越容易重复计算。机架价格里已经包含的冷板和电源架,不能在设施 BOM 中再次加入;设施变电站不能算进单颗 GPU 成本。只有先确定边界,才能知道“内容增长”究竟发生在芯片、系统,还是建筑。
为什么有些结果必须标为“不可计算”
供应链研究最常见的错误,是为了让表格看起来完整而填入一个未经披露的数字。假如知道 GB300 NVL72 的机架功率,就可以用计算功率除以每机架功率,估算 100 MW 设施能部署多少套;如果不知道 Rubin 或 Atlas 系统功率,沿用上一代或采用未经验证的媒体估计,就会把假设伪装成可比事实。
“不可计算”并不表示系统没有价值,也不表示研究到此结束。它告诉读者:
- 哪个关键分母仍然缺失;
- 哪些比较只能停留在方向而不能进入总量;
- 哪个未来披露会让估值发生变化;
- 哪些供应商类别可能受益,但尚不能分配收入。
在投资研究中,一个明确的空白通常比一个精确但虚假的数字更有用。空白可以被后续披露填补,错误数字却会让整张模型看似严谨、实际失真。
系统内容增长不等于供应商收入增长
Rubin 的 HBM 带宽、NVLink 和主机内存明显高于 GB300,说明下一代平台需要更多高带宽内存、交换、网络与电能质量内容。这是类别需求。要把类别需求归属到某家公司,还要再穿过四道门:
- 公司是否被客户正式列为供应商;
- 产品是否完成认证并进入量产;
- 公司获得多少份额、以什么价格供货;
- 相关收入对公司整体利润是否足够大。
例如,某家内存厂被确认导入 HBM4,只能证明它参加了供应链,不能证明获得一半份额;一家液冷厂出现在参考设计中,也不等于每座园区都会采购其产品。公开证据没有给出份额时,本章只保留关系,不把它换算成收入。
这也解释了为什么“最确定”与“最大上行”可能不在同一家公司。平台所有者和代工厂关系最明确,估值也可能已经反映大量增长;较小部件供应商的收入弹性更大,供应份额和客户集中却更不确定。读者应先建立物理需求,再单独评估证券可达性、收入暴露和价格,而不是从供应商名单直接跳到买入结论。
标准化的目的不是预测订单,而是让不同系统说同一种语言
NVIDIA NVL72 是一座机架,Atlas 900 A3 是 16 柜系统,Atlas 950 路线图上限则达到 160 柜。直接比较系统价格、卡数或柜数,就像用一辆轿车和一列火车比较“谁更大”:答案显然,却没有告诉投资者哪一种以更低成本完成相同运输任务。
100 MW 标准化试图提供共同分母。它固定 IT 名牌容量、计算占比、PUE 和利用率,再问不同系统能部署多少、设施侧需要多少资本、每年消耗多少电。只有系统功率得到可靠披露时,才计算系统数量;否则只保留设施侧共同情景。
标准化仍然不是项目预测。一座真实园区会受到数据厅布局、冗余、备用容量、网络与存储比例、环境温度和客户负载影响。这里的价值在于比较:当所有平台使用同样规则时,下一代系统把更多钱推向内存、网络、冷却还是电力,就能够被看见。
先从芯片走到电网,再比较四套系统
加速器必须经过六层嵌套的物理体系协同,才能转化为有用算力。开篇结构图在这里对应一条阅读顺序:封装、托盘、机架、数据厅、已投运设施,最后是电网与资源。
| 层级 | 新增的物理内容 | 主要约束 | 本章核算方式 |
|---|---|---|---|
| 加速器封装 | 逻辑裸片、HBM、基板、封装互连 | 良率、HBM 供应、先进封装 | 平台 BOM |
| 托盘或板卡 | CPU、GPU、本地内存、NIC/DPU、电压转换、冷板 | 信号完整性、功率密度、热传递 | 平台 BOM |
| 机架 / 超节点 | 纵向扩展交换托盘、线缆、电源架、歧管、管理系统 | 互连带宽、机架功率、可维护性 | 平台 BOM |
| 数据厅 | 母线槽、CDU 与换热器、列级网络、物理部署 | 并发可维护性、水力与配电 | 除有源 IT 外的设施 BOM |
| 园区 | 变电站、开关设备、UPS/储能、发电、中央冷却、建筑外壳 | 并网周期、水、施工与调试 | 设施 BOM |
| 电网 | 场址边界以外的发电与输电 | 可用容量、价格与交付时间 | 排除远端电网工程;电力计入经常性运营开支 |
系统中存在两条流。电力从并网点流向变压器和变电站、中压开关设备、UPS 或储能与备用发电、低压配电、母线槽,最终进入机架电源架。热量反向流动:从芯片到冷板、技术侧回路、CDU 与换热器、设施水回路,再经冷水机组、干冷器或冷却塔排向环境。机架是交接点:随计算系统交付的冷板或电源架属于平台 BOM;设施侧 CDU、母线槽或冷水机组属于设施 BOM。物理架构参见美国能源部数据中心设计指南。
因此,本章对每个平台分别回答三个问题:
- 一个加速器封装里有什么?
- 已披露的完整系统边界里有什么?
- 在不猜测的前提下,100 MW 已投运 IT 铭牌容量能说明什么?
发电、输电、冷却与数据中心约束详见 §2.3;加速器架构见 §2.5;纵向与横向扩展互连见 §2.6;HBM 与先进封装见 §2.7;晶圆代工集中度见 §2.8;设备与 EDA 见 §2.9;材料见 §2.10;资本形成见 §2.11;出口管制与技术栈分化见 §2.12。公司基本面、上市渠道与证券层面的风险回报分析见第五部分。

| 锚定平台 | 封装边界 | 完整系统边界 | 100 MW 标准化 |
|---|---|---|---|
| Blackwell Ultra | 一个 B300 封装 | 一个 GB300 NVL72 机架 | 由已披露的 142 kW 机架功率上限支持 |
| Vera Rubin | 一个 Rubin 封装 | 一个 Vera Rubin NVL72 机架 | 不可计算:机架功率未披露 |
| Ascend 910C | 一个 910C 加速器 | 一套 16 柜 Atlas 900 A3 | 不可计算:系统功率未披露 |
| Ascend 950DT | 一个 950DT 路线图加速器 | 1,024 卡演示配置,以及单独披露的 8,192 卡路线图上限 | 不可计算:两种系统的功率均未披露 |
美国已部署:Blackwell Ultra / GB300 NVL72
身份与生命周期。 已确认|已出货 NVIDIA 于 2025 年 3 月 18 日发布 Blackwell Ultra,并在 2026 年 7 月 25 日证据截止日前将 GB300 NVL72 描述为已经上市。本章系统边界是一座 NVL72 计算机架:72 个 Blackwell Ultra GPU 与 36 个 Grace CPU,不含周边数据厅、外部存储或园区网络。NVIDIA GB300 产品页与发布公告是生命周期依据。
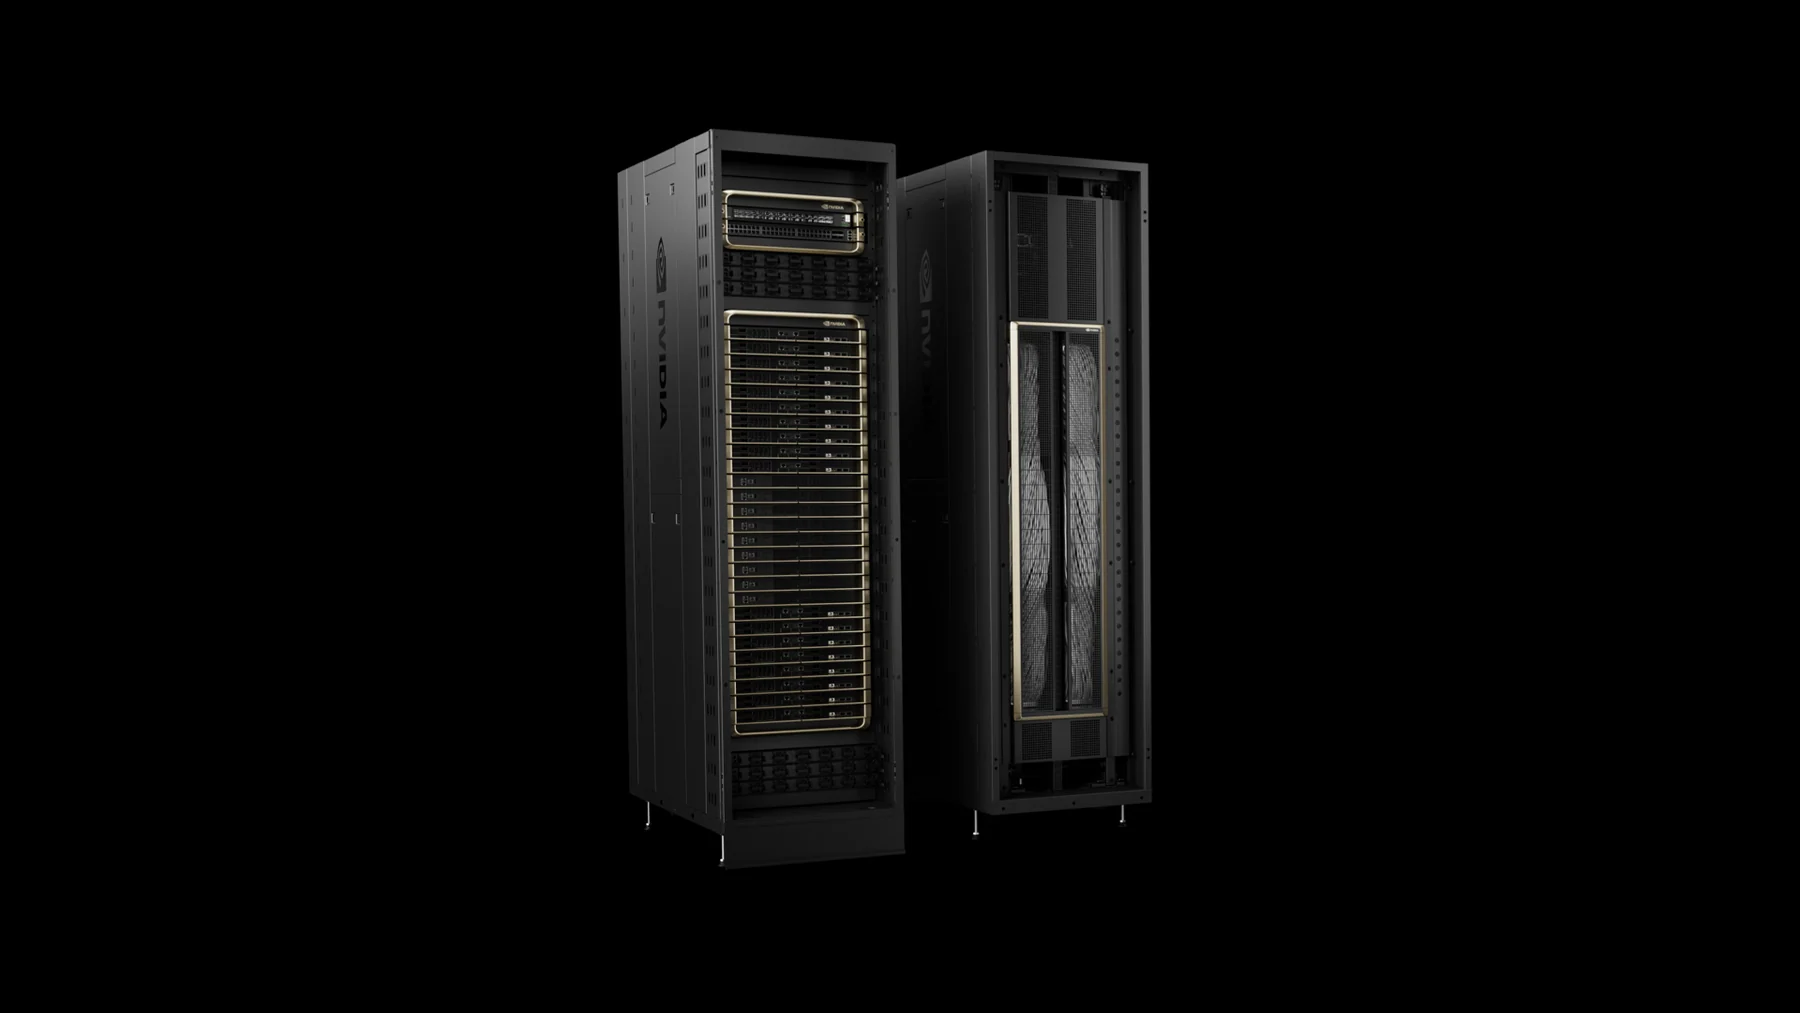
72 颗 GPU 如何变成一座 142 kW 机架
一个 Blackwell Ultra B300 是由两个光罩尺寸受限的计算裸片组成的统一封装,二者通过 NVIDIA 的 10 TB/s NV-HBI 连接。已披露规格包括 2080 亿个晶体管、八颗 12 层堆叠的 288 GB HBM3E、最高 8 TB/s HBM 带宽、1.8 TB/s 双向 NVLink 5 带宽,以及最高 1.4 kW 总图形功率。1.4 kW 是 GPU 封装上限,并非平均机架负载假设。NVIDIA 将制程标为 TSMC 4NP。NVIDIA Blackwell Ultra 架构说明定义了封装边界。
完整机架包含 18 个计算托盘,每个托盘有四个 GPU 和两个 Grace CPU;另有九个 NVSwitch 托盘,每个含两个 NVSwitch ASIC;此外还有 72 个 ConnectX-8 适配器、18 个 BlueField-3 DPU,以及八个 33 kW 电源架。NVIDIA 标示机架最高功率为 142 kW。直接液冷属于系统物理边界。NVIDIA GB300 参考架构提供了托盘与机架数量。
| GB300 边界 | 精确披露内容 | 证据 |
|---|---|---|
| 一个 B300 封装 | 2 个计算裸片;2080 亿个晶体管;288 GB HBM3E;8 TB/s HBM;1.8 TB/s NVLink;最高 1.4 kW TGP | 已确认 |
| 一个计算托盘 | 4 个 B300 GPU;2 个 Grace CPU;4 个 ConnectX-8 适配器;1 个 BlueField-3 DPU | 已确认 |
| 一个 NVL72 机架 | 18 个计算托盘;72 个 GPU;36 个 CPU;9 个交换托盘;18 个 NVSwitch ASIC | 已确认 |
| 机架功率与冷却 | 最高 142 kW;直接液冷 | 已确认 |
| 机架 GPU 内存总量 | 20.736 TB | 推算:72 × 288 GB |
| 机架 HBM 带宽总量 | 576 TB/s | 推算:72 × 8 TB/s |
功率披露让 GB300 成为唯一可放进 100 MW 分母的平台
基准设施把 100 MW IT 铭牌容量中的 80 MW 分配给计算,网络、存储、管理与安全分别占 10 MW、7 MW 和 3 MW。用 80 MW 除以已披露的 142 kW 机架最大负载,得到 563.38 个 GB300 NVL72 机架。计算占比在 70%–88% 的敏感性范围对应 492.96–619.72 个机架。这些是工程占位等价值,不是采购预测;数据厅几何布局、搁浅容量、维护预留和实际利用率都会降低或重新分配可部署数量。
| 100 MW IT 铭牌容量情景 | 计算占比 | 计算功率 | 采用的 GB300 功率 | 标准化 NVL72 机架数 |
|---|---|---|---|---|
| 低计算分配 | 70% | 70 MW | 每机架最高 142 kW | 492.96 |
| 基准 | 80% | 80 MW | 每机架最高 142 kW | 563.38 |
| 高计算分配 | 88% | 88 MW | 每机架最高 142 kW | 619.72 |
这些机架的成本不计入设施资本开支。100 MW 设施 BOM 排除有源加速器、CPU、内存、存储、机架网络、光学器件和有源 IT 备件。
具名参与者很多,公开收入份额仍然很少
即使最终集成向美国需求所在地靠近,当前机架仍由全球制造体系完成。NVIDIA(NVDA)设计平台。TSMC(TSM)采用 4NP 制造 Blackwell Ultra;NVIDIA 另行确认 TSMC 亚利桑那州工厂生产 Blackwell 系列,但公开证据没有给出 GB300 晶圆在亚利桑那与台湾之间的分配。Micron Technology(MU)称其 36 GB、12 层 HBM3E 已导入 GB300,SOCAMM 亦为该平台共同开发。SK hynix(000660.KS)展示过采用其 36 GB HBM3E 的 GB300 模组。Foxconn(Hon Hai Precision,2317.TW)称自己是试产供应商,其 Ingrasys 部门参与液冷设计。Wistron(3231.TW)表示其 Fort Worth D1 工厂量产 GB300 板卡。
| 角色 | 具名实体 | 有证据支持的地域 | 关系 | 没有证据支持的内容 |
|---|---|---|---|---|
| 平台设计 | NVIDIA | 美国 | 已确认 | 客户或地域组合 |
| 逻辑制造 | TSMC | 4NP 已确认;亚利桑那 Blackwell 系列生产另行确认 | 已确认制程 | GB300 亚利桑那/台湾分配 |
| HBM3E / SOCAMM | Micron | 总部位于美国;此处未披露制造分配 | 已确认导入 | 单位或收入份额 |
| HBM3E | SK hynix | 总部位于韩国;此处未披露制造分配 | 已有模组证据 | 单位或收入份额 |
| 试产 / 冷却 | Foxconn / Ingrasys | 以台湾为中心的制造网络 | 已确认参与 | 机架分配份额 |
| 板卡生产 | Wistron | 得克萨斯州 Fort Worth | 已确认 | 平台整体分配 |
当前收入窗口已经打开,但价值分配仍需验证
当前一代最直接的商业敞口已进入生产:NVIDIA 的平台芯片与系统、具名内存伙伴的 HBM3E、TSMC 4NP 晶圆、NVIDIA 机架内部的交换与网络芯片,以及板卡/系统集成。关键限制是分配份额。参与关系已经确认,但各伙伴供应 GB300 单元、晶圆或 HBM 堆叠的比例并未披露,因此本章不会把导入关系换算成供应商收入。
未来 12–36 个月的问题,是 Rubin 爬坡期间 GB300 能维持多久的批量过渡角色,以及具名内存与集成供应商能否在切换中保留或扩大内容量。未来 3–7 年的问题,则是年度平台节奏会把每一代变成短暂的收入波峰,还是服务、替换、网络与设施内容池的扩大足以抵消更快淘汰。
GB300 的风险来自客户集中、供应同步与快速换代
- 142 kW 最大规格可能高于平均运行功率,因此标准化机架数是保守的占位等价值,而非能耗预测。
- 已确认的供应关系并不能证明供应份额、价格或毛利率。
- TSMC 亚利桑那生产是系列层面的表述;为 GB300 指定地域份额会夸大证据。
- Rubin 快速导入可能压缩 GB300 收入窗口,即便存量支持与设施支出仍在持续。
- 台湾集中度、出口管制与资本周期是跨层风险;参见 §§2.8、2.11 与 2.12。
美国爬坡中:Vera Rubin / NVL72
身份与生命周期。 量产爬坡|目标 2026 年下半年广泛供应 NVIDIA 表示 Rubin 芯片已于 2026 年 1 月全面投产,并在 2026 年 5 月 31 日前点名正在制造 Vera Rubin 系统的整机厂商。截至观察日,广泛上市仍以 2026 年下半年为里程碑。因此,“量产爬坡”比“仅有路线图”或“已全面部署”都更准确。本章边界是一座 Vera Rubin NVL72 计算机架。NVIDIA 更大的五机架 POD 还加入独立的 Vera CPU、Groq 3 LPX、BlueField-4 STX 与 Spectrum-6 SPX 机架;这些配套机架不计入下方 NVL72 BOM。NVIDIA Rubin 发布公告与量产爬坡公告确定其状态。
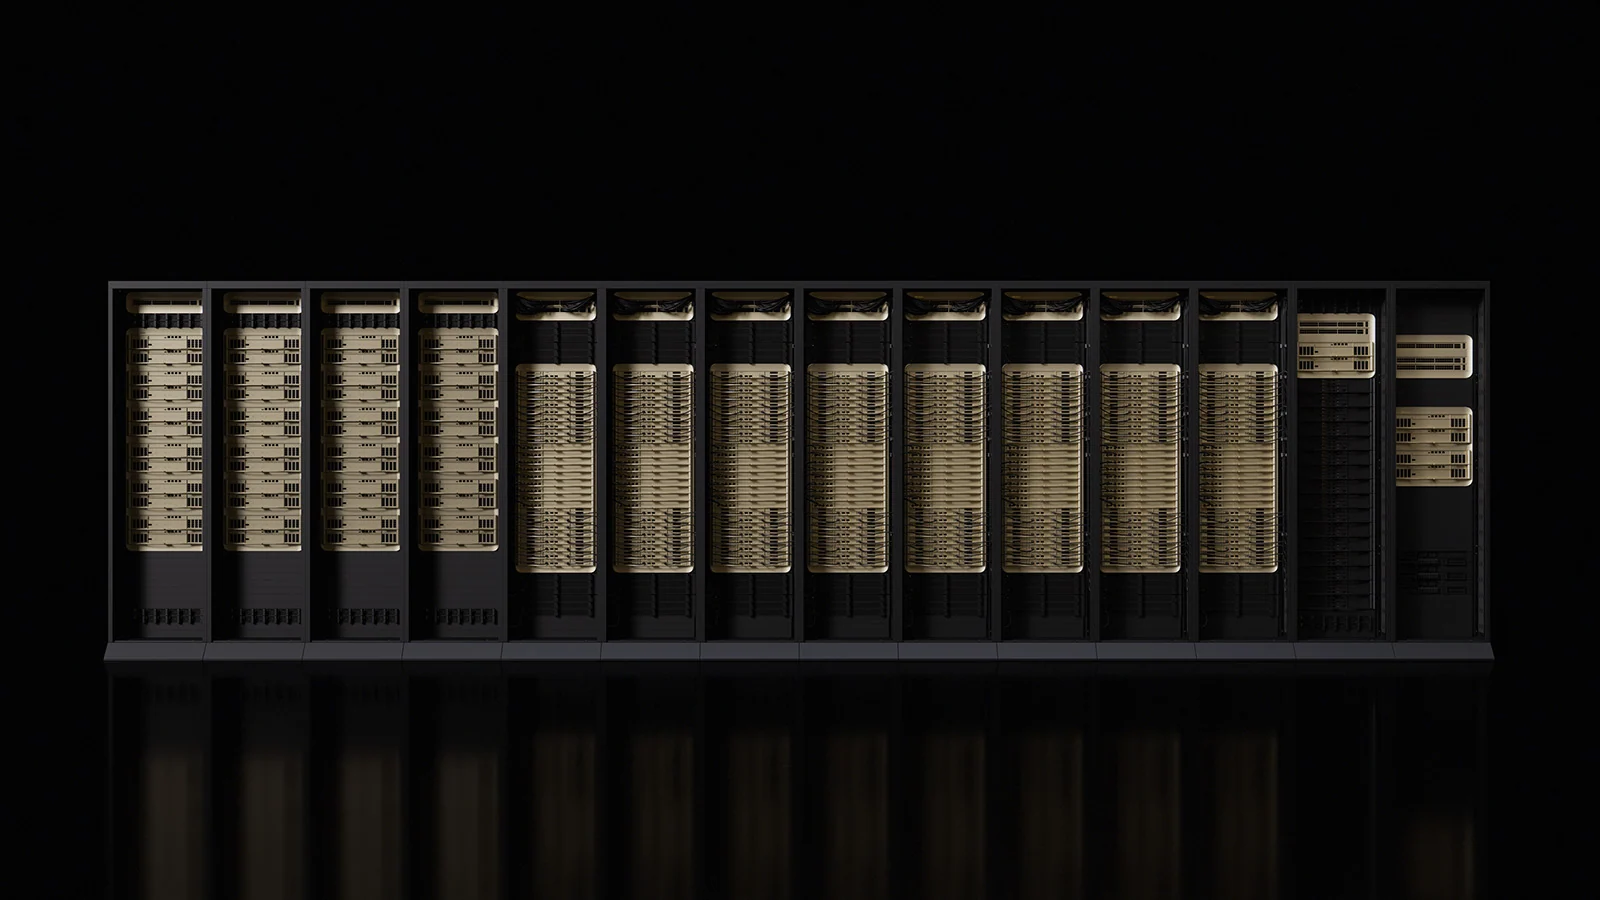
GPU 数量不变,内存与互连几乎重写整座机架
一个 Rubin GPU 包含两个由 NV-HBI 连接的光罩尺寸受限计算裸片。NVIDIA 初步规格为 3360 亿个晶体管、288 GB HBM4、22 TB/s HBM 带宽、50 PFLOPS NVFP4 推理算力,以及 3.6 TB/s 双向 NVLink 6 带宽。截止日前,制程节点、HBM 堆叠数量、封装供应商与 GPU TGP 均未披露,因此保持空白,不以分析师报告补值。Rubin GPU 架构说明与Vera Rubin 规格页定义了封装。
机架仍有 72 个 GPU 与 36 个 CPU。NVIDIA 展示每个计算托盘包含两个 Vera Rubin Superchip,即四个 GPU 与两个 CPU,由此推得 18 个计算托盘。公司披露 36 个 NVLink 6 交换 ASIC,每个交换托盘含四个 ASIC,由此推得九个交换托盘。18 与九个托盘数是算术推断,并非单独发布的项目。平台引入 BlueField-4、每 GPU 1.6 Tb/s 横向扩展连接、45°C 温水单相直接液冷、机架级功率平滑,以及约为 Blackwell Ultra 六倍的本地能量缓冲。NVIDIA 称相同占地内热性能接近翻倍,但没有公布机架 kW 值。NVIDIA 平台架构说明支持这些关系。
| Vera Rubin 边界 | 精确或推导内容 | 证据 |
|---|---|---|
| 一个 Rubin 封装 | 2 个计算裸片;3360 亿个晶体管;288 GB HBM4;22 TB/s HBM;3.6 TB/s NVLink | 第一方初步规格 |
| 一个 NVL72 机架 | 72 个 Rubin GPU;36 个 Vera CPU | 已确认配置 |
| 计算托盘 | 18 | 按每托盘 4 GPU、2 CPU 推算 |
| NVLink 交换 ASIC / 托盘 | 36 个 ASIC / 9 个托盘 | 36 个已披露;按每托盘 4 个推算为 9 个 |
| 机架 GPU 内存 | 20.736 TB | 72 × 288 GB |
| 机架 HBM 带宽 | 约 1,584 TB/s;平台比较中取整显示为 1,580 | 72 × 22 TB/s |
| 机架功率 | 未披露 | 未披露,未计入总量 |
有设施需求信号,没有功率就没有可比机架数
Rubin 对设施的影响方向清晰,却不能在系统层做数值标准化。温水液冷会改变排热设计;功率平滑与更大的本地缓冲增加机架级电能质量内容;纵向和横向带宽翻倍则加重网络负担。但这些披露都没有给出机架功率。复用 GB300 的 142 kW,或采用第三方 Rubin 估算,都会制造虚假的每 100 MW 系统数量比较。因此,标准化数量为 不可计算。
| 设施问题 | 证据支持的结论 | 尚不可得的信息 |
|---|---|---|
| 冷却架构 | 45°C 温水、单相直接液冷;更高流量歧管 | 设施 WUE、流量需求与每机架冷却装置资本开支 |
| 电能质量 | 机架级功率平滑;约 6× Blackwell Ultra 本地能量缓冲 | 机架输入功率与缓冲部件价值 |
| 密度 | 相同机架占地内热性能接近 2× | 机架 kW 与数据厅可部署数量 |
| 100 MW 标准化 | 设施侧全国成本与运营开支情景仍适用 | 每 100 MW 的 Rubin NVL72 机架数 |
下一代导入关系比量产收入走得更快
NVIDIA 点名 Dell Technologies(DELL)、Hewlett Packard Enterprise(HPE)、Lenovo(0992.HK)、Super Micro Computer(SMCI)、Foxconn、Quanta/QCT(2382.TW)、Wistron 与 Wiwynn(6669.TW)为正在生产 Vera Rubin 系统的厂商。这证明参与,不证明份额。Micron 表示,为 Vera Rubin 设计的 36 GB、12 层 HBM4 与 SOCAMM2 自 2026 年 Q1 起批量出货。Samsung Electronics(005930.KS)称量产 HBM4 与 SOCAMM2 为 Vera Rubin 设计。SK hynix 表示与 NVIDIA 就 Vera Rubin 内存建立多年共同开发与供应关系,但所引披露未分配具体 Rubin HBM SKU。Wistron 表示 Fort Worth 场址将生产 Vera Rubin Superchip。
| 角色 | 具名实体或群组 | 关系 | 证据边界 |
|---|---|---|---|
| 平台设计与机架互连 | NVIDIA | 已确认 | 产品规格;商业分配不适用 |
| HBM4 / SOCAMM2 | Micron | 已确认设计关系与批量出货 | Vera Rubin 导入;供应商份额未披露 |
| HBM4 / SOCAMM2 | Samsung | 已确认设计关系 | 供应商份额未披露 |
| 内存合作 | SK hynix | 媒体报道的联合开发与供应关系 | 未引用具体 SKU 分配 |
| Superchip 生产 | Wistron | 已具名的 Fort Worth 未来生产计划 | 产量与开工日期未披露 |
| 系统制造 | Dell、HPE、Lenovo、Supermicro、Foxconn、QCT、Wistron、Wiwynn | 已确认参与 | 未披露单位分配 |
| 晶圆厂 / 封装供应商 | 未披露 | 不可计算 | 不将任何名称纳入敞口分析 |
Rubin 把增量价值推向 HBM4、主机内存与电能质量
最强的内容增长信号发生在不变的 72-GPU 机架边界内。HBM 带宽增长约 174%;NVLink 机架带宽翻倍;交换 ASIC 数量从 18 增至 36;每 GPU 横向扩展连接翻倍;主机 CPU 内存从 17.28 TB 增至 54 TB。潜在受益类别因此包括平台所有者、通过认证的 HBM4 与 SOCAMM2 厂商、纵向与横向扩展芯片、高速互连部件、功率平滑硬件、液冷部件和系统集成。只有具名且有披露支持的关系才归属到公司;类别需求不换算成供应商收入。
近期商业窗口从 2026 年的内存认证与系统厂商生产开始,延伸至广泛上市和客户部署。结构性窗口更长:更热、更依赖带宽的机架会前置设施电气与冷却内容,并提高网络在系统价值中的占比。供应商建模的核心风险是产品节奏:认证可在终端系统放量前产生经济意义,但公告日期并不是收入确认日期。
Rubin 的风险是路线同步与未披露功率
- 已发布规格为初步版本,在广泛上市前可能变化。
- 没有机架功率披露,就不能计算每 100 MW 的机架数、电力成本或有源 IT 资本开支。
- 晶圆厂、封装供应商、HBM 分配、系统厂商份额与 BlueField-4 数量均未披露。
- 具名设计关系不能揭示价格、利润率、期限或排他性。
- 五机架 Vera Rubin POD 与单机架 NVL72 是不同边界;合并二者会重复计算配套基础设施。
中国已部署:Ascend 910C / Atlas 900 A3
身份与生命周期。 已确认|已出货 Ascend 910C 是加速器;Atlas 900 A3 是实体 16 柜 SuperPoD;CloudMatrix384 是华为云对该架构的服务部署,不是另一张硬件 BOM。华为称截至 2025 年 9 月,已向 20 多个客户出货 300 多套 A3 SuperPoD;截至 2026 年 7 月 17 日,商业部署超过 750 套。厂商报告的部署数可以确定商业状态,但不是经独立审计的装机记录。华为 A3 产品页、2025 年 9 月发布信息和2026 年 7 月更新共同定义边界与状态。
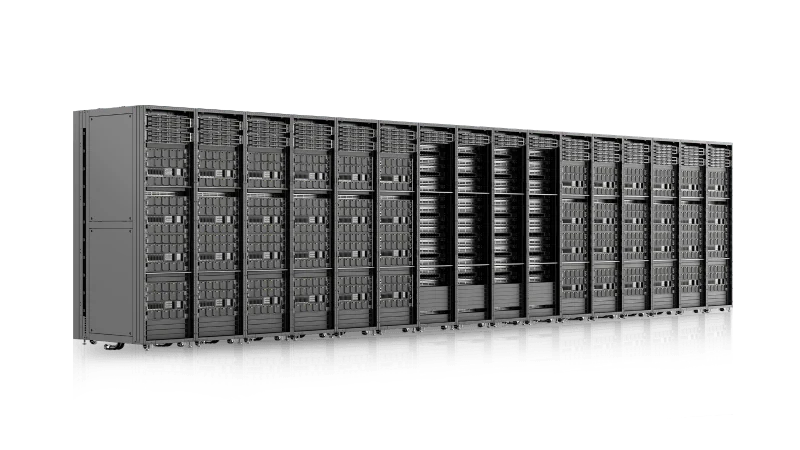
384 个加速器如何组成一套 16 柜系统
Ascend 910C 的公开封装边界较为稀疏:每个 NPU 配备 128 GB 封装内存,带宽为 3.2 TB/s。华为没有披露 HBM 代际或供应商、裸片数量、制程节点、封装厂商、加速器功率或价格。Reuters 报道称华为计划使用 SMIC N+2 生产 910C;这一关系仍为 媒体报道,并非已确认分配。因此,Reuters 报道与华为产品规格分开处理。
完整 A3 由 12 个液冷计算柜与四个风冷总线柜组成,包含 384 个 Ascend 910C NPU、192 个 Kunpeng 920 CPU、1,536 条 DDR5 DIMM 和 480 个 2.5 英寸硬盘。系统提供 48 TB 封装内存总量、784 GB/s 双向裸片间带宽,以及 288.7–307.2 PFLOPS FP16 算力,具体取决于已发布的运行/配置区间。输入架构为双路三相 380 V AC。系统总功率与单柜功率均未披露。
| Atlas 900 A3 边界 | 已披露内容 | 证据 |
|---|---|---|
| 一个 Ascend 910C | 128 GB 封装内存;3.2 TB/s 内存带宽 | 已确认 |
| 实体系统 | 16 柜:12 个计算柜 + 4 个总线柜 | 已确认 |
| 加速器 / CPU | 384 个 Ascend 910C / 192 个 Kunpeng 920 | 已确认 |
| 主机内存 / 存储 | 1,536 条 DDR5 DIMM / 480 个 2.5 英寸硬盘 | 已确认数量 |
| 封装内存总量 | 48 TB | 已披露合计值;与 384 × 128 GB 一致 |
| FP16 算力 | 288.7–307.2 PFLOPS | 已披露区间 |
| 冷却 | 计算柜液冷;总线柜风冷 | 已确认 |
| 系统功率 | 未披露 | 不可计算 |
已部署不等于已经具备统一设施分母
A3 已经商业部署,但部署状态不能解决标准化问题。没有系统总功率,16 柜占地就无法换算成每 100 MW 系统数。机柜数也不能替代功率:其中四个是总线柜,冷却模式不同,已披露的输入电压也不能说明负载。因此,诚实的 100 MW 结果是 不可计算。
中国全国设施情景仍可描述其周边已投运基础设施。基准 100 MW IT 铭牌容量设施在 1.25 PUE 下有 125 MW 总设计需求,在 65% 利用率下年耗电约 711.75 GWh,模型设施侧资本开支约为 8.95 亿美元。这些值不能决定计算分配中可容纳多少套 A3。
国产系统已经存在,外部供应关系仍然不透明
华为及其 HiSilicon 设计部门拥有加速器与系统架构;Kunpeng 也是华为处理器家族。因此,当前架构把可见的设计与平台价值集中在一家私营、对多数投资者不可直接投资的集团内。SMIC 的晶圆代工关系来自报道,未由平台分配确认。华为在所引产品披露中没有点名内存、先进封装、光学器件、存储、液冷或制造供应商。
| 角色 | 具名实体 | 关系 | 投资渠道含义 |
|---|---|---|---|
| 加速器与系统设计 | Huawei / HiSilicon | 已确认 | 华为为私营公司;无直接公开股权投资渠道 |
| 主机 CPU | Huawei Kunpeng | 已确认 | 同样集中于私营平台 |
| 逻辑制造 | SMIC(0981.HK / 688981.SS) | 910C 制造关系来自媒体报道 | 存在公开市场渠道,但平台分配未确认 |
| 封装内存 | 未披露 | 不可计算 | 不归属供应商 |
| 封装、光学与冷却 | 未披露 | 不可计算 | 类别需求可见,公司分配不可见 |
A3 的投资价值先取决于利用率与可见供应商收入
A3 装机基础形成了对华为自研加速器、Kunpeng CPU、大量 DDR5 与存储、总线柜互连、液冷和系统集成的当前需求,但供应商图谱很快中断。外部关系中看似最可投资的 SMIC,也是平台记录中确定性最低的具名关系,因为它仅为报道状态,而且没有披露分配比例。
未来 12–36 个月,具有商业意义的证据是已报告部署基础与持续国产替代。未来 3–7 年,该架构展示了一条中国路径:用系统规模与受严密控制的互连弥补单颗加速器的相对劣势。这可能扩大国内内存、光学、封装与冷却需求,却不能指出由哪家上市供应商获取。供应商认证、本地化政策与华为采购披露,比自上而下的份额假设更适合作为领先指标。
A3 的风险是功耗、良率、软件与低披露共同叠加
- 华为报告的部署数不是经审计的装机量。
- 封装制程、内存供应商、封装链、系统功率与价格均未披露。
- 报道中的 SMIC 参与不能当作已确认供应分配。
- 美国工业与安全局在 2025 年 5 月专门就 Ascend 910C 发布指引,增加政策与交易风险;参见 BIS 一般禁令 10 指引与 §2.12。
- A3 的 16 柜系统不能直接与 NVL72 单机架或 Atlas 950 路线图上限比较。
中国下一代:Ascend 950DT / Atlas 950 SuperPoD
身份与生命周期。 路线图|已有 1,024 卡实物演示 Ascend 950DT 的目标时间是 2026 年第四季度。Atlas 950 是一组系统配置。华为在 2026 年 7 月 17 日世界人工智能大会上展示了一套实体 1,024 卡 Atlas 950 SuperPoD。另行披露的路线图上限则是 8,192 卡、160 柜,目标同为 2026 年第四季度。实物演示与路线图上限不可互换。截至观察日,1,024 卡系统已经展示,8,192 卡最大配置尚未出货。华为 WAIC 披露和2025 年路线图主题演讲确定了这一区别。
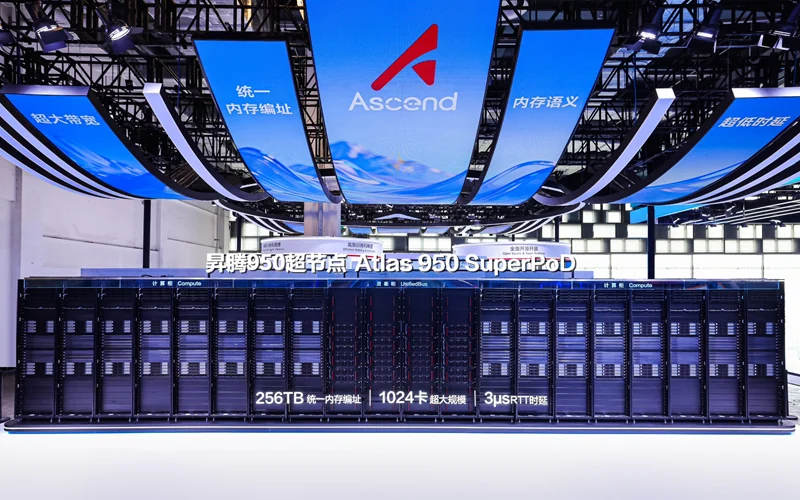
必须把芯片路线图、1,024 卡演示与 8,192 卡目标拆开
华为的 Ascend 950DT 路线图规格包括 144 GB HiZQ 2.0 HBM、4 TB/s 内存带宽、每芯片 2 TB/s 互连带宽、1 PFLOPS FP8 与 2 PFLOPS FP4。制程节点、裸片数、封装供应商、HBM 制造商、封装功率和价格仍未披露。
2026 年 7 月的实体演示使用 1,024 张加速器卡,并披露 1 EFLOPS FP8、2 EFLOPS FP4、256 TB 全局寻址内存、TB 级 NPU 互连与 3 μs 往返延迟。具体加速器卡型号没有披露。内存数字提供了重要的勾稽警示:256 TB 除以 1,024 卡等于每卡 256 GB,与单独披露的 144 GB 950DT 封装路线图不一致。因此,演示系统作为独立配置记录,不会被直接标记为“1,024 × 950DT”。
路线图最大配置是在 1,000 多平方米内放置 160 柜、8,192 张加速器卡:128 个计算柜,每柜 64 卡,另有 32 个通信柜。华为描述其采用全光 UnifiedBus 互连,具备 8 EFLOPS FP8、16 EFLOPS FP4、1,152 TB 内存总量和约 16.3 PB/s 互连带宽。冷却、系统功率、CPU、主机内存、存储、精确光学器件数量与系统价格均未披露。
| Atlas 950 边界 | 已披露内容 | 状态 |
|---|---|---|
| Ascend 950DT 封装路线图 | 144 GB HiZQ 2.0 HBM;4 TB/s 内存;2 TB/s 互连;1 PF FP8;2 PF FP4 | 2026 年第四季度路线图 |
| 实体演示 | 1,024 卡;1 EF FP8;2 EF FP4;256 TB 全局内存;3 μs RTT | 2026 年 7 月 17 日已演示 |
| 演示卡身份 | 未披露;总内存隐含每卡 256 GB | 不得标为 950DT |
| 路线图上限 | 8,192 卡;160 柜;>1,000 m²;1,152 TB 内存 | 目标 2026 年第四季度 |
| 路线图互连 | 128 个计算柜 + 32 个通信柜;全光 UnifiedBus;~16.3 PB/s | 路线图 |
| 系统功率与冷却 | 未披露 | 不可计算 |
物理规模已经可见,设施经济性仍无法标准化
路线图超过 1,000 平方米的占地和 160 柜说明,相对于单机架,这是一套园区级系统;但面积不是能量分母。没有加速器卡、机柜或系统总功率,就不能把 1,024 卡演示配置或 8,192 卡路线图上限换算为每 100 MW 系统数。功率估算会进一步传导至冷却、电气资本开支、年耗能与供应商内容量,把一个缺乏依据的假设放大到整个模型。因此,所有这类输出均为 不可计算。
| 配置 | 物理证据 | 100 MW 结果 |
|---|---|---|
| 1,024 卡演示 | 已展示真实硬件;具体卡型与总功率未披露 | 不可计算 |
| 8,192 卡路线图上限 | 已披露机柜、面积、内存、算力与互连目标;尚未出货 | 不可计算 |
| 中国基准设施 | $894.92M 设施侧资本开支;125 MW 总设计功率;共同基准假设下 711.75 GWh/年 | 有效的全国基准,但不能推导 Atlas 950 系统数 |
类别需求巨大,具名外部供应商证据最弱
华为拥有 Ascend 设计、HiZQ 品牌与 UnifiedBus 架构。这证明架构控制权,并不能揭示背后的制造链。所引披露没有公开分配 HBM 制造商、晶圆厂、先进封装商、光模块与光学部件供应商、冷却厂商或最终系统制造商。因此,不向任何外部供应商归属 Atlas 950 收入或份额。
| 角色 | 具名实体 | 证据 | 尚未解决的问题 |
|---|---|---|---|
| 加速器与系统设计 | Huawei / HiSilicon | 路线图架构方 | 制造分配 |
| HBM 架构/品牌 | Huawei HiZQ 2.0 | 路线图规格 | 内存制造商与封装链 |
| 纵向扩展互连 | Huawei UnifiedBus | 已确认架构方 | 实际光学、线缆与交换部件供应商 |
| 晶圆厂 | 未披露 | 不可计算 | 制程、地点、良率与分配 |
| 冷却与系统集成 | 未披露 | 不可计算 | 厂商、拓扑、功率与经济性 |
Atlas 950 的内容增长尚未等于近期可投资收入
相较 A3 封装,950DT 路线图把内存容量从 128 增至 144 GB,增幅 12.5%;带宽从 3.2 增至 4 TB/s,增幅 25%。在已披露完整系统的两个极端边界上,加速器从 A3 的 384 个增至 Atlas 950 路线图上限的 8,192 个,机柜从 16 增至 160,内存总量从 48 增至 1,152 TB。这些 21.33×、10× 与 24× 比率描述的是已披露配置边界,不是出货预测。
需求方向是:每套已部署最大配置需要更多加速器芯片、HBM 容量、全光纵向扩展连接、电源转换与液冷。除华为以外,“谁获得收入”仍未解决,因为外部供应商没有具名。近期催化剂是认证,以及能否在 2026 年第四季度目标前后实际交付;结构性问题则是 UnifiedBus 与国内内存/封装产能能否以可接受的良率、功耗和成本扩张。把类别增长映射到上市公司之前,投资者应要求看到采购订单、供应商认证或已确认收入的证据。
Atlas 950 的风险是把路线图规模误当成交付能力
- 1,024 卡演示与 8,192 卡路线图上限是不同系统;合并二者会制造虚假的出货表述。
- 演示系统隐含的每卡 256 GB 与另行披露的 950DT 144 GB 不一致,因此卡型仍不明。
- 系统功率、冷却拓扑、CPU 与存储数量、晶圆厂、HBM 供应商、封装商和光学器件分配均未披露。
- 2026 年第四季度是路线图目标,不是批量出货证据。
- 出口管制可能延缓国内制造投入,同时强化本地化需求;参见 §§2.9、2.10 与 2.12。
下一代没有简单增加 GPU,而是把钱移向带宽与系统
代际差分 BOM 比静态 BOM 更有用,因为它能在供应商份额尚未知时,指出可寻址内容量在哪里增长。它也揭示两套生态的不对称:NVIDIA 保持加速器数量不变,却在单机架内强化内存、互连、主机内存、冷却与电能质量;华为披露的下一步同时扩大封装与最大系统边界,但制造链和功率链仍有更多空白。

| 生态指标 | 当前 | 下一代 | 变化 | 证据与可比性 |
|---|---|---|---|---|
| 美国:每套 NVL72 的 GPU | 72 | 72 | 0% | 同一单机架边界 |
| 美国:每机架 GPU 内存 | 20.736 TB | 20.736 TB | 0% | 容量相同;HBM3E → HBM4 |
| 美国:每机架 HBM 带宽 | 576 TB/s | ~1,580 TB/s | +174.3% | 由已披露单 GPU 数值推导;下一代取整 |
| 美国:每机架 NVLink 带宽 | 130 TB/s | 260 TB/s | +100% | 平台比较 |
| 美国:横向扩展带宽 | 0.8 Tb/s/GPU | 1.6 Tb/s/GPU | +100% | 平台比较 |
| 美国:NVLink 交换 ASIC | 18 | 36 | +100% | 当前已披露;下一代数量已披露 |
| 美国:CPU 内存 | 17.28 TB | 54 TB | +212.5% | 同一机架边界 |
| 美国:机架功率 | 最高 142 kW | 不可计算 | 不可计算 | Rubin 机架功率未披露 |
| 中国:封装内存 | 128 GB | 144 GB | +12.5% | 910C 实际值对 950DT 路线图 |
| 中国:封装内存带宽 | 3.2 TB/s | 4 TB/s | +25% | 910C 实际值对 950DT 路线图 |
| 中国:被比较系统的加速器数 | 384 | 8,192 | 21.33× | A3 已出货,对 Atlas 950 路线图上限;不是单位销量预测 |
| 中国:机柜数 | 16 | 160 | 10× | 同样警示:当前配置对路线图上限 |
| 中国:加速器内存总量 | 48 TB | 1,152 TB | 24× | 当前配置对路线图上限 |
| 中国:系统功率 | 不可计算 | 不可计算 | 不可计算 | 无标准化比较 |
由此得到三点投资解读。第一,数量可以不变,内容量仍可增长:Rubin 的 GPU 数量不变,却掩盖了带宽、交换与主机内存的大幅提升。第二,系统规模本身就是策略:华为路线图依靠更多卡与全光互连形成有竞争力的系统总量。第三,披露质量决定模型质量:中国看似更大的代际变化,在系统功率和供应分配公布前,仍不能换算为设施需求或供应商收入。
机架之外,还有一张十亿美元级设施 BOM
共同设施边界为 100 MW 已投运 IT 铭牌容量。低、基准、高情景分别采用 1.15、1.25、1.35 PUE,以及 50%、65%、80% 利用率。总设计功率因此为 115、125、135 MW,年耗电为 503.70、711.75、946.08 GWh。美国与中国采用相同物理区间,避免在缺乏依据时嵌入效率优势;国家差异只通过施工、电力与水成本体现。

| 100 MW IT 铭牌容量指标 | 美国 低 / 基准 / 高 | 中国 低 / 基准 / 高 | 解读 |
|---|---|---|---|
| 已安装设施侧资本开支 | $1,118.15M / $1,371.87M / $1,814.12M | $660.71M / $894.92M / $1,174.05M | 排除土地、有源 IT、税费与融资 |
| 总设计功率 | 115 / 125 / 135 MW | 115 / 125 / 135 MW | IT 铭牌容量 × PUE |
| 场址年耗电 | 503.70 / 711.75 / 946.08 GWh | 503.70 / 711.75 / 946.08 GWh | 总功率 × 利用率 × 8,760 小时 |
| 电费 | $25.19M / $61.35M / $132.45M | $25.54M / $60.15M / $106.60M | 全国/区域电价敏感性 |
| 直接用水量 | 87,600 / 256,230 / 490,560 m³ | 相同物理区间 | WUE 为 0.2 / 0.45 / 0.7 L/kWh IT 电量 |
| 水与污水处理 | $0.18M / $0.90M / $3.92M | $0.03M / $0.22M / $0.66M | 成本远小于电力,但可用性仍可能构成约束 |
| 设施维护 | $22.36M / $54.88M / $108.85M | $13.21M / $35.80M / $70.44M | 已安装设施资本开支的 2% / 4% / 6% |
| 标准化系统 | 仅 GB300:计算占比敏感性下为 492.96 / 563.38 / 619.72 个机架 | 不可计算 | 其他平台功率未披露 |
基准设施资本开支仅汇总叶节点,避免把小计与其子项重复相加。
| 基准设施侧资本开支叶节点 | 美国 | 中国 |
|---|---|---|
| 电气装置 | $567.672M | $370.312M |
| 冷却装置 | $390.275M | $254.589M |
| 建筑外壳与建筑工程 | $106.439M | $69.433M |
| 承包商前期费用与专业费用 | $118.265M | $77.148M |
| 公用事业延伸预留 | $94.612M | $61.719M |
| 业主、调试与设施备件预留 | $94.612M | $61.719M |
| 总计 | $1,371.874M | $894.920M |
成本差异来自基准地域,并不能证明美国或中国设施在运营上更优。施工基准对地区、劳动力市场、公用事业范围与采购时间尤其敏感。模型采用 Turner & Townsend 2025 成本指数方法及其液冷分配,并以 Cushman & Wakefield 亚太施工指南确定中国区间。PUE 与利用率边界参考 LBNL 美国数据中心能源报告、中国国家能效披露,以及 Uptime Institute 超大型数据中心分析。
一项路线图要穿过哪些阶段才会成为供应商收入
供应商证据按顺序出现。架构发布形成类别需求;认证或导入识别潜在供应商;开始制造证明实物参与;出货证明商业产品;客户投运带来利用率和持续设施运营开支;已报告收入才证明经济价值被捕获。大多数公开供应链说法都停在最后一步之前。

| 证据阶段 | 美国当前 / 下一代示例 | 中国当前 / 下一代示例 | 投资者可得出的结论 |
|---|---|---|---|
| 架构 / 路线图 | Rubin HBM4、NVLink 6、温水冷却;目标 2026 年下半年上市 | 950DT 与 8,192 卡 Atlas 950 的 2026 年第四季度目标 | 仅说明类别需求方向 |
| 导入 / 认证 | Micron 与 Samsung 描述 Vera Rubin 内存设计;SK hynix 关系为报道状态 | HiZQ 与 UnifiedBus 是华为架构;外部供应商未具名 | 仅在明确披露时确认具名参与 |
| 制造 | GB300 在 Wistron Fort Worth 生产;Vera Rubin 系统厂商已具名 | A3 已商业部署;Atlas 950 实体 1,024 卡演示 | 产品存在或正在进入制造;不能推导供应商份额 |
| 出货 / 上市 | GB300 已出货;Rubin 正向广泛上市爬坡 | A3 已出货;8,192 卡 Atlas 950 尚未出货 | 收入窗口可能已经开启,但价值与分配仍未知 |
| 投运 / 利用率 | 不建模特定客户部署 | 华为报告 >750 套 A3 部署 | 说明已安装状态;不能推导有效吞吐 |
| 已确认供应商收入 | 本数据集不提供平台产品线层面数据 | 本数据集不提供平台产品线层面数据 | 需要财报或供应商披露;不得从 BOM 数量倒推 |
时间纪律可以避免两个错误:路线图标记不等于积压订单,已确认导入也不等于收入份额估算。未来 12–36 个月应关注部件认证、开工制造、广泛上市、系统功率披露与已投运部署。未来 3–7 年应观察内存、网络与设施内容量是否持续快于加速器数量增长,以及中国本土供应商能否变得足够可见,从而把类别增长与经济价值捕获区分开来。
最确定的供应关系,不一定拥有最大的投资上行
下表是筛选工具,不是建议。“市场准入”考察投资者能否获得直接公开股权敞口;“证据”考察平台关系是否有文件支持;“集中度”考察敞口对单一客户或平台的依赖;“替代”考察其他合格供应商或架构接管该内容的难易程度。这些维度不应被平均成一个不透明的综合分。

| 敞口 | 12–36 个月催化剂 | 3–7 年结构性位置 | 公开市场渠道 | 平台证据 | 集中度 / 替代风险 |
|---|---|---|---|---|---|
| NVIDIA 平台芯片、NVLink 与网络 | GB300 出货;Rubin 广泛上市与量产爬坡 | 一体化机架架构可捕获更大的系统 BOM | 直接:NVDA | 两个美国锚点均为高 | 平台集中度高;NVL72 内部架构难以替代,但客户仍有其他选择 |
| 美国 HBM 与 SOCAMM — Micron | GB300 HBM3E/SOCAMM 与 Rubin HBM4/SOCAMM2 导入 | 内存带宽与主机内存内容量快于 GPU 数量增长 | 直接:MU | 具名导入证据高;分配未知 | 内存价格周期;Samsung 与 SK hynix 替代 |
| 韩国 HBM — SK hynix 与 Samsung | GB300 模组证据;Rubin 关系与设计 | HBM4 复杂度、带宽与容量提高每套系统价值 | 韩国市场直接投资 | 高/报道混合;分配未知 | 多源供应、认证时点与内存周期风险 |
| TSMC 领先制程制造 | 已确认 GB300 4NP 需求 | 先进逻辑与封装仍难替代 | 直接:TSM / 2330.TW | GB300 证据高;Rubin 晶圆厂未披露 | 客户与台湾集中度极高;制程领先降低替代性 |
| 美国/台湾系统厂商 | GB300 生产与 Rubin 制造爬坡 | 系统级集成、冷却与电源内容增加 | 可通过具名上市厂商直接投资 | 参与证据高;单位份额未知 | 透明度低,组装产能可能被替代 |
| 设施电气与冷却类别 | 100 MW 项目在美国基准情景需要约 $958M 电气加冷却装置;中国为 $625M | 更高密度液冷系统加深从电网到芯片的内容 | 通过第五部分类别筛选获取敞口 | 设施证据与供应商无关;无平台供应商归属 | 项目时点、区域定价、客户集中度与厂商竞争 |
| Huawei / HiSilicon 平台 | A3 装机基础;Atlas 950 能否按路线图交付 | 国内全栈控制与 UnifiedBus 生态 | 无直接公开股权;华为私营 | 架构证据高,外部分配证据低 | 单一平台集中度极高;政策支持与政策风险并存 |
| SMIC 报道中的 910C 制造 | 当前一代持续生产证据将构成催化 | 国内领先制程替代具有战略价值 | 直接:0981.HK / 688981.SS | 媒体报道,分配未确认 | 良率、工具、出口管制与客户集中度 |
| 中国内存、封装、光学与冷却类别 | 供应商认证或采购订单披露 | Atlas 规模系统可显著扩大国内内容 | 可能可投资,但此处不指定发行人 | 低 / 未披露 | 归属风险高;不得把类别需求等同于发行人收入 |
证据最充分的美国敞口,也是最显而易见且通常最集中的敞口。中国看似最大的内容增长,外部供应商披露最弱,直接投资渠道也最少。这并非忽视它的理由,而是提高证据门槛的理由。完成本章的物理筛选后,还应在第五部分进一步检验估值、流动性、上市渠道与公司特定风险。
哪些尚未披露的数据会真正改变结论
以下披露将显著改善模型:
- Vera Rubin NVL72 的最大与典型机架输入功率是多少,各自采用什么边界?
- Rubin 采用哪种晶圆制程与先进封装流程,地域分配如何?
- Rubin HBM4 在 Micron、Samsung 与 SK hynix 之间如何分配,通过认证的出货何时成为已确认平台收入?
- 一套 Vera Rubin NVL72 内有多少 BlueField-4、电源架和本地能量缓冲模块?
- Atlas 900 A3 的总功率与单柜功率、冷却流量、光学器件数量和供应商分配是什么?
- 1,024 卡 Atlas 950 演示采用哪款加速器卡,为什么隐含的每卡 256 GB 与 950DT 路线图的 144 GB 不同?
- 8,192 卡 Atlas 950 最大配置的功率、冷却拓扑与有源部件数量是什么?
- 谁制造并封装 Ascend 950DT 与 HiZQ 2.0 内存,哪些光学供应商通过 UnifiedBus 认证?
- 在设施层面,全国施工与电力情景背后有多大的地区差异,哪些成本由客户直接采购、哪些由承包商交付?
- 在软件、利用率与模型工作负载保持一致后,每个已投运 MW 的有效训练和推理吞吐如何比较?
最后一个问题需要另一套工作负载与软件基准,因此不在本章的物理供应链模型内。共同的 100 MW 分母只标准化物理占位与设施经济性,并不标准化有效算力、模型质量或收入。
注意事项与假设
- **截止日与生命周期:**资料截至 2026 年 7 月 25 日。状态标签描述的是该日期,而非永恒不变的产品状态。
- **系统边界:**GB300 与 Vera Rubin 均采用一个 NVL72 计算机架;Atlas 900 A3 采用一套 16 柜 SuperPoD;Atlas 950 将 1,024 卡演示配置与 8,192 卡路线图最大配置分开保留。
- **证据政策:**已确认、已报道与透明推导的值可以进入事实表;路线图值必须带路线图标签;推测值绝不进入总计、代际差异或可投资性矩阵。
- **区间:**低/基准/高表示情景不确定性,而非统计置信区间。
- **设施范围:**计入的资本开支从场址变压器/变电站边界开始,覆盖配电、设施侧冷却与排热、建筑外壳/核心、承包商成本、公用事业延伸预留、业主成本、调试与设施备件。
- **设施资本开支排除项:**土地、税费、融资、远端电网工程、有源加速器、CPU、内存、存储、机架网络、光学器件、机架冷板、有源 IT 备件与项目收入。
- **经常性范围:**电力、直接用水与例行设施维护分别建模;排除有源 IT 服务合同、折旧与重大中期翻新。
- **物理假设:**计算占比为 70%/80%/88%;PUE 为 1.15/1.25/1.35;利用率为 50%/65%/80%;直接 WUE 为每 kWh IT 电量 0.2/0.45/0.7 升。1.0×/1.1×/2.0× 关键保障容量比用于描述设计敏感性,不会再次乘入资本开支。
- **货币:**设施输出以美元表示。中国电力与施工输入按已记录的模型汇率约定换算;这些是情景,不是汇率预测。
- **供应商分配:**具名参与者、导入关系或制造场址都不意味着排他性、单位份额、价格或利润率。
- **投资用途:**本章是供应链与投资研究,不构成个性化投资建议。
方法与来源说明
每个展示值都对应平台状态、系统配置、BOM 行、设施假设、供应商关系与公开来源;衍生值保留公式及依赖。设施总计只汇总最底层项目,避免小计与子项重复;资本开支与运营开支分开;只有在系统功率已经披露时,才计算 100 MW 可容纳的系统数量;未披露的供应商份额保持为空。
事实观察边界为 2026 年 7 月 25 日。核心一手来源包括 NVIDIA 的 GB300 与 Vera Rubin 产品及架构披露、华为的 Atlas 900 A3 与 Atlas 950 披露、美国能源部设施设计指南、LBNL 与中国国家能效资料、Turner & Townsend 与 Cushman & Wakefield 施工基准、美国 EIA 与中国电力资料、EPA 与市政水价,以及 GAO/NASA 维护基准。Reuters 只用于明确标为“媒体报道”的供应关系。
本章是跨层总结,不替代底层章节。电力与冷却市场见 §2.3;加速器竞争见 §2.5;网络见 §2.6;内存与封装见 §2.7;晶圆代工地域见 §2.8;生产工具与 EDA 见 §2.9;材料见 §2.10;融资见 §2.11;政策见 §2.12。公司投资渠道、基本面与风险档案以第五部分为准。