第 2.5 章|AI 芯片与加速器
“谁卖出最多 AI 芯片”至少有三个互不兼容的答案:自研 ASIC 可能赢得颗数,商用 GPU 可能赢得收入,而真正交付的有效算力取决于整套系统。投资者不应追逐一个份额数字,而要追踪谁控制系统、利润和客户迁移成本。
CPU 擅长按顺序快速处理许多不同任务,AI 加速器则让数千个计算单元同时执行神经网络最常见的矩阵运算。它牺牲一部分通用性,换取更高并行效率。模型训练和推理因此从传统服务器转向 GPU、TPU 和各种专用 ASIC。
可是,一颗加速器不会独立工作。它需要旁边的 HBM 持续供应数据,需要芯片间互连同步,需要数据中心网络连接更多机架,还需要电源、液冷、驱动、编译器和软件库。集群越大,单颗芯片的峰值性能越不能代表客户真正得到的产出。
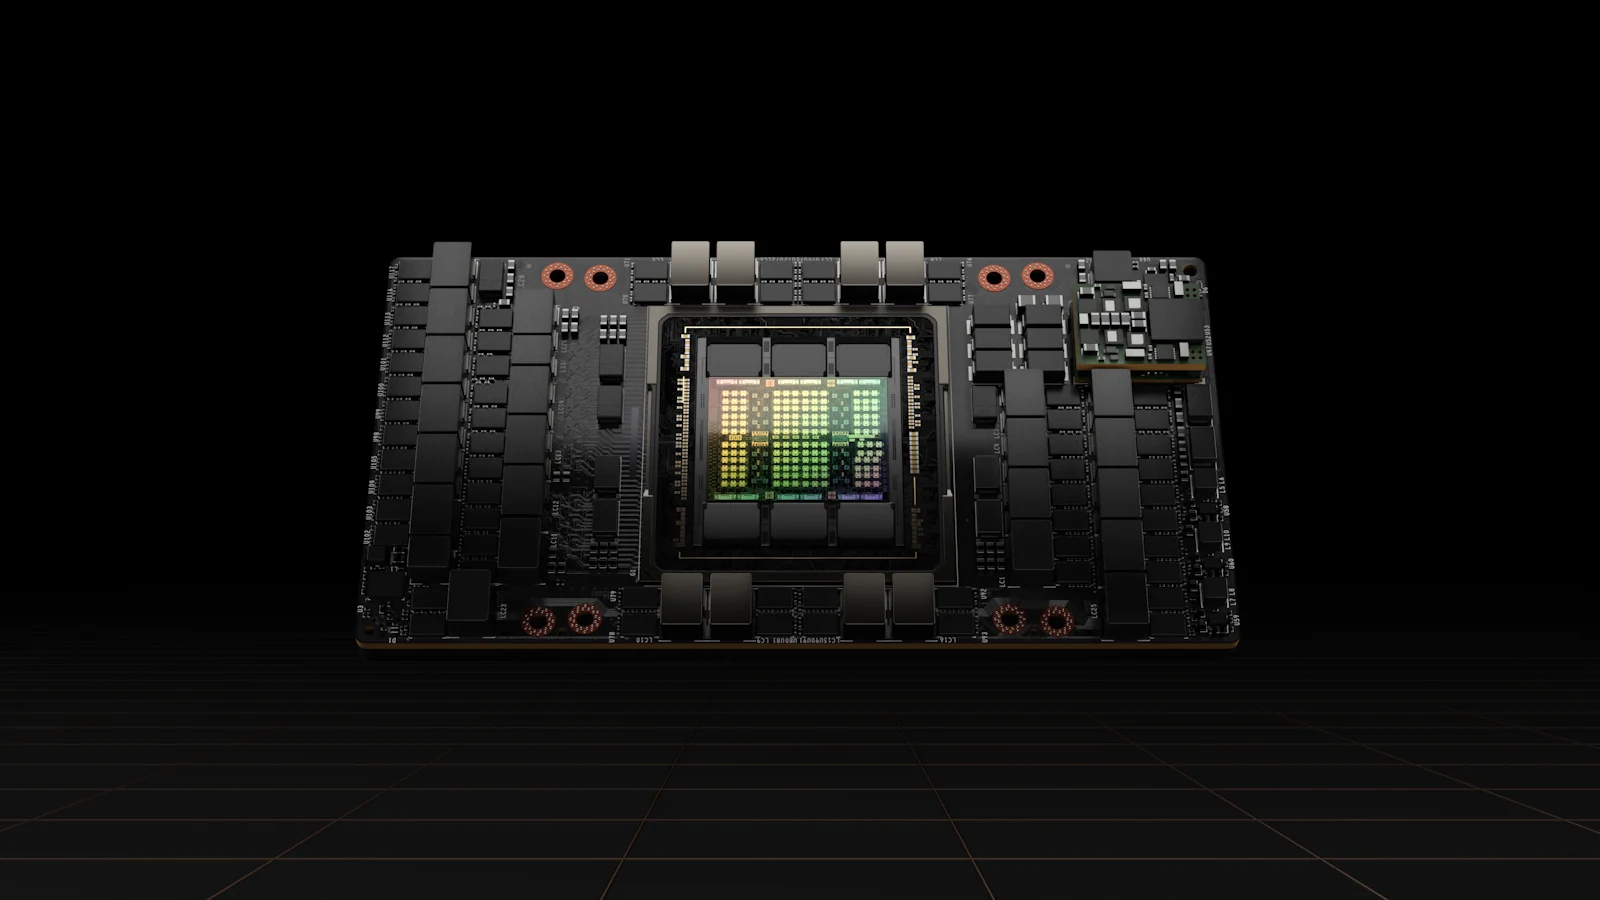
过去投资者按芯片颗数和平均售价理解半导体;现在更合适的销售单位越来越接近一整座机架。
先分清三张份额榜
Google、Amazon、Microsoft、Meta 和 OpenAI 都在扩大自研芯片。固定、规模巨大、长期重复的内部任务很适合 ASIC:设计者可以删掉不需要的通用能力,用更低功耗完成特定工作。按颗数统计,自研芯片可能成为最大阵营。
但颗数不等于收入。一颗只在内部使用、成本较低的推理 ASIC,与一套包含 GPU、CPU、网络、液冷和软件的数百万美元机架,不是同一种经济单位。内部芯片甚至没有外部销售收入,只通过降低云成本创造价值。
因此,任何“AI 芯片份额”都应先说明分母:
| 份额口径 | 它真正衡量什么 | 最容易出现的误读 |
|---|---|---|
| 出货颗数 | 部署了多少加速器 | 把不同价格、性能和用途的芯片等同 |
| 供应商收入与利润 | 谁向外部客户收费并保留毛利 | 忽略云厂商自研芯片创造的成本节省 |
| 理论算力 | 芯片规格相加 | 忽略网络、软件、故障与利用率 |
| 有效算力 | 实际完成任务的速度、稳定性和成本 | 数据难获得,容易用厂商基准替代 |
| 系统内容 | 芯片之外还能销售多少网络、CPU、软件与服务 | 把整机架收入误认为纯 GPU 收入 |
这几张榜完全可以同时出现不同冠军。Nvidia 的颗数份额下降,不妨碍它通过更高系统内容扩大收入;云厂商自研 ASIC 没有外部芯片收入,也可能显著改善自身云毛利;中国系统连接更多单颗较弱的芯片,理论总量很大,实际有效算力仍要经过利用率和软件验证。
芯片已经变成一套共同交付的系统
一颗 AI 加速器的性能至少受五项约束:
- 计算格式。 FP8、FP4 等低精度格式用少量精度换取更高吞吐,但不同任务对精度容忍度不同。
- 内存容量与带宽。 芯片再快,数据供不上也只能等待。
- 芯片间互连。 单个模型可能跨越多颗 GPU,通信速度决定扩展效率。
- 数据中心网络与故障恢复。 数万颗芯片中任何节点故障,都可能影响整个训练任务。
- 软件。 编译器、算子库和开发工具决定理论性能能否被工程师使用。
Nvidia 的战略,是把这些环节一起设计并一起销售。客户购买的不再只是 GPU 板卡,而是包含 GPU、CPU、NVLink、交换机、网卡、电源、液冷和软件的整机架。这样既提高单笔订单价值,也把竞争门槛从“做出一颗芯片”提高到“按时交付一整套可运行系统”。
主要阵营的真实控制点如下:
| 芯片家族 | 厂商 | 类型 | 真正竞争位置 |
|---|---|---|---|
| Blackwell / GB300 → Vera Rubin | Nvidia | 商用 GPU | CUDA、网络与整机架标准 |
| Instinct MI300 → MI400 | AMD | 商用 GPU | 最可信第二来源与价格竞争 |
| Gaudi → Jaguar Shores | Intel | 商用加速器 | 远期产品和美国制造选择权 |
| TPU / Ironwood | 自研 ASIC | 最成熟的超大云自研路线 | |
| Trainium / Inferentia | AWS | 自研 ASIC | 大规模内部训练与推理 |
| Maia、MTIA | Microsoft、Meta | 自研 ASIC | 自有云与内部负载 |
| XPU | OpenAI + Broadcom | 自研 ASIC | 计划中的大规模定制路线 |
| Ascend 910C / 950 | 华为 | 中国主力 | 昇腾、CANN、网络与系统 |
| 思元 MLU、DCU | 寒武纪、海光 | 中国加速器 | 本土公开市场敞口 |
| BR、MXC、MTT | 壁仞、沐曦、摩尔线程 | 中国加速器 | 多条国产路线 |
| 定制设计平台 | Broadcom、Marvell | ASIC 赋能者 | 为多家云厂商提供设计与互连 |
Nvidia 的护城河是一张同步更新的时间表

Nvidia 以接近一年一代的节奏推进 Blackwell、Blackwell Ultra、Vera Rubin 和后续系统。Vera Rubin NVL72 把 72 颗 Rubin GPU、36 颗 Vera CPU、HBM4、NVLink 和整套网络放进统一平台。厂商在观察日尚未公布可与现有系统直接比较的完整机架功率,因此第三方估计必须标为估算;更远期 Rubin Ultra 的高功率数字仍属于路线图情景,不能当作已交付产品事实。12
一年一代最难复制的部分不是 GPU 设计本身,而是所有供应链必须同时到位:
- TSMC 按时交付逻辑裸片;
- SK Hynix、Samsung、Micron 提供通过认证的 HBM;
- CoWoS 和基板能容纳更大封装;
- 网络芯片、光模块和线缆准备好;
- 数据中心供电与液冷能支持更高机架密度;
- CUDA、库和框架在发布日可用;
- OEM、云厂商和客户已经完成验证。
任何一项延迟,整机架收入都会延迟。Nvidia 把更多环节纳入平台,获得更大收入,也承担更集中执行风险。系统化并不是没有代价:更新过快会缩短旧设备经济寿命,客户可能推迟采购等待下一代,供应链的某个小故障还会影响整个产品节奏。
Nvidia 真正销售的是交付确定性。前沿模型公司支付溢价,不只是为了更高峰值 FLOPS,而是希望在明确日期获得一套经过验证、软件可用、可以扩展到万卡的系统。
为什么机架级销售改变利润池
只卖裸芯片时,收入大致等于出货量乘单价;卖整机架后,供应商可以同时捕获 CPU、交换机、网卡、互连和软件价值。客户也更难逐项议价,因为系统性能依赖整体匹配。
这会产生三个投资后果。
第一,Nvidia 的收入增长可能快于 GPU 颗数增长。第二,网络与系统业务不再只是附属品,而成为平台锁定的一部分。第三,AMD 或其他竞争者即使推出性能接近的芯片,也必须补齐机架、网络、软件和服务,才能真正争夺同一预算。
因此,比较 Nvidia 和 AMD 不能只看芯片基准,还要比较:
- 每个机架的可交付时间;
- 客户从安装到生产的周期;
- 大规模集群利用率与故障恢复;
- 软件迁移和工程师培训成本;
- 每单位有效算力的总拥有成本。
第 2.13 章将把 Blackwell Ultra、Vera Rubin、Ascend 910C 与 Ascend 950 从封装、系统到 100 MW 设施统一拆解,避免用一颗 GPU 对比一个 SuperPoD。
AMD 是第二来源,Intel 更像远期制造选择权
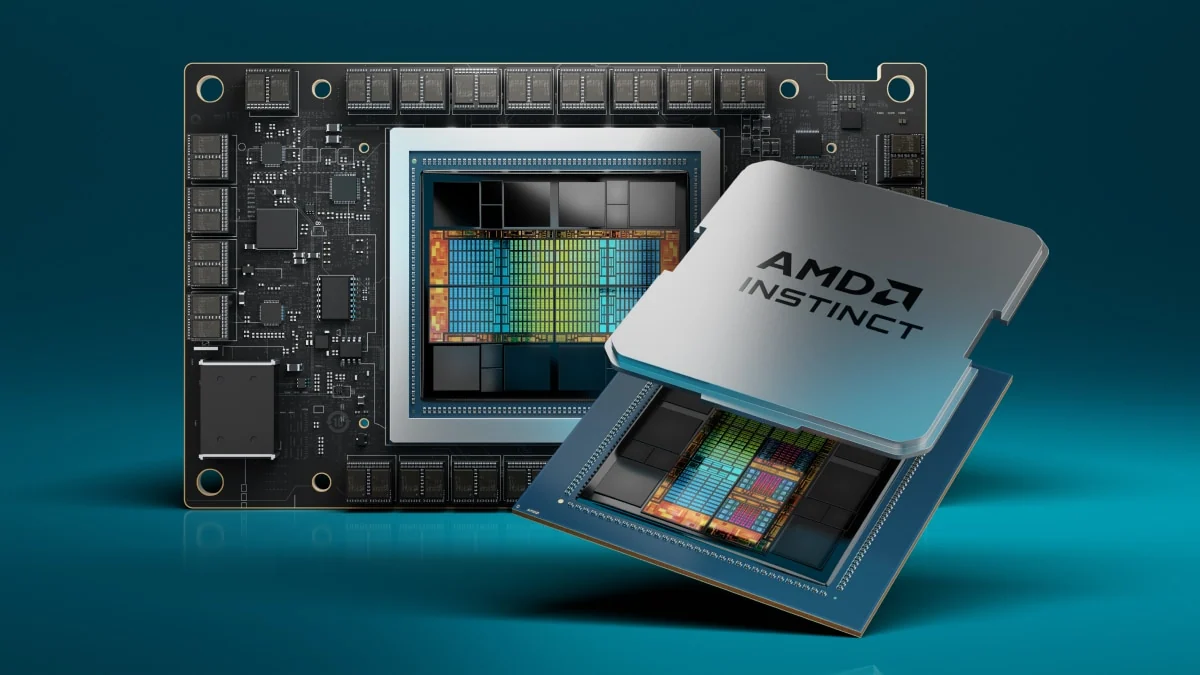
客户不希望所有算力依赖一家供应商。第二来源可以降低价格、缓解交付风险,并在技术路线变化时提供选择。AMD 的 Instinct 系列和 MI400/Helios 机架因此拥有真实机会。
AMD 的优势不是必须立即超过 Nvidia,而是达到“足够好、可以部署”的门槛。只要软件、网络和供应稳定,模型公司就愿意把部分工作负载分配给第二平台。大型客户承诺提供需求锚,但设计中标还要经过量产、集群验证、利用率和后续续单,才会变成稳定利润。
AMD 的主要限制是安装基础与软件生态。ROCm 进步能够减少迁移成本,却仍要在真实生产中证明长期可靠。价格折扣也可能帮助拿到份额,却让收入增长不一定带来同等利润。
Intel 的 Gaudi 未达到最初预期,后续 Jaguar Shores 与硅光子提供远期可能。对公开市场投资者而言,Intel 更重要的 AI 逻辑可能逐渐来自美国先进制造和政策支持,而不是近期加速器份额。把“GPU 份额反转”和“美国代工选择权”混成一个估值故事,会误判时间与风险。
自研 ASIC 会优先拿走什么工作负载

GPU 的优势是通用与成熟,适合模型和算法仍在快速变化的前沿训练。ASIC 的优势是针对特定任务优化,在负载足够稳定、规模足够大时降低功耗和成本。
所以,自研芯片更可能按以下顺序替代:
- 搜索、推荐等长期稳定的内部推理;
- 规模大、模型变化较少的生成式 AI 推理;
- 已固定架构的部分训练;
- 最后才是最前沿、变化最快的大模型训练。
这不是一条绝对路线,但解释了为什么 ASIC 颗数可以快速上升,而 Nvidia 仍控制高价值前沿系统。云厂商也不必向外部销售自研芯片,只要内部使用能减少采购和电力成本,就已经创造回报。
Broadcom 与 Marvell 是这条路线的“赋能者”。它们帮助云厂商设计定制计算、互连和网络,可以同时参与多个项目,不必押注单一云平台。不过,客户数量仍然很少,单个项目延期、下一代设计转移或客户自行开发,都可能显著影响收入。
判断 ASIC 替代速度,不能只记录流片和发布。更有价值的证据是:
- 是否形成连续几代产品;
- 是否在内部大规模部署并披露利用率或成本优势;
- 是否从内部任务扩展到外部云客户;
- 软件能否让应用在不同硬件间平滑迁移;
- 项目收入是否足以覆盖高额设计和制造投入。
中国正在用系统规模弥补单点差距
先进 GPU 受限后,中国形成以华为昇腾为核心、寒武纪、海光及多家国产厂商补充的平行体系。Ascend 910C 与 Atlas 900 A3 已进入部署,Ascend 950 系列和 Atlas 950 SuperPoD 指向更大规模集群。
差距必须按层表达,而不是只说“追上”或“落后”。单颗芯片性能、能效、HBM 容量、先进制造良率和软件成熟度仍受约束;华为通过连接更多加速器、自有网络和系统软件,换取可用总算力。
这条路线的经济代价也很清楚。若完成同一任务需要更多芯片,就需要更多交换机、线缆、电力、冷却和故障管理。节点越多,某个部件失效的概率越高,系统软件必须更有效地隔离故障和调度工作。
因此,中国算力不能只按卡数比较。更有意义的是:
同一模型、同一精度、同一完成时间下,需要多少芯片、多少电力、多少人工调优,以及集群能维持多高利用率?
华为的优势是能够同时控制芯片、CANN、网络、服务器和云,形成系统学习循环。政策采购也能提供首批需求。它的上限则取决于中芯国际先进制程良率、国产 HBM、先进封装和软件生态。任何一项持续改善,都会放大整个本土市场的学习速度;任何一项停滞,也会成为系统上限。
路线图只有变成交付,才有投资价值
半导体行业充满发布日期、性能倍数和长期合作。投资者需要把一颗芯片的生命周期分成至少六个阶段:
| 阶段 | 说明 | 可以支持的投资判断 |
|---|---|---|
| 架构公布 | 厂商描述设计方向 | 只能说明路线,不代表收入 |
| 流片与样片 | 首批硅片或工程样品 | 技术风险下降,量产风险仍高 |
| 客户认证 | 在目标系统中验证 | 开始形成设计中标 |
| 量产爬坡 | 良率、HBM、封装与软件同步 | 供应链收入开始可见 |
| 系统部署 | 集群安装并验收 | 可以观察交付能力 |
| 生产利用 | 客户持续运行并续购 | 才证明经济竞争力 |
路线图产品不能按已交付产品进入收入或 100 MW 总量。厂商披露与第三方报道也要区分;规格、功率和出货数字需要明确证据等级。
谁能把芯片增长变成股东回报
不同证券捕获的是不同利润:
- Nvidia:整机架、网络、软件税和年度平台节奏;
- AMD:第二来源与份额提升,但要承担软件投入和价格竞争;
- Broadcom、Marvell:云厂商自研芯片与网络,多项目分散但客户集中;
- 云厂商:自研 ASIC 通过成本节省与云毛利创造价值;
- 寒武纪、海光等中国公司:国产替代与政策需求,同时承担估值、技术和可交易性风险;
- 制造与 HBM 供应商:不决定架构,却可以从每代内容增长和资格认证获利。
投资者应同时跟踪三条利润路径:商用加速器毛利、自研芯片给云厂商带来的成本节省,以及系统周边内容增长。只看芯片出货,会漏掉后两条;只看 TAM,又会忽略竞争、资本强度和买入价格。
哪些证据会改变当前判断
当前基准判断是:商用 GPU 仍控制前沿训练和高价值系统,自研 ASIC 会持续吸收稳定推理,中国则通过更大系统与垂直整合弥补单点差距。
以下证据会改变这一判断:
- 自研 ASIC 不仅内部大规模部署,还能向外部客户提供通用、易迁移的训练与推理平台;
- Nvidia 在推理中的收入份额持续下降,而且整机架和软件收入无法抵消;
- AMD 或其他平台在大规模前沿训练中实现接近的部署速度、利用率和总成本;
- 中国先进制造、HBM、封装和 CANN 同时出现连续量产改善;
- 模型效率增长长期快于使用量,使整条加速器需求曲线下移。
最重要的结论不是某家公司永远领先,而是:
芯片投资已经从比较一颗硅片,变成比较谁能把计算、内存、网络、冷却和软件在同一天交付,并让客户持续使用。
图表与关键证据来源
Footnotes
-
NVIDIA Vera Rubin Pod: Seven Chips, Five Rack-Scale Systems, One AI Supercomputer. NVIDIA;访问于 2026 年 7 月 25 日。 ↩ ↩2
-
AI server rack power roadmap. TrendForce,2026 年 6 月 25 日;访问于 2026 年 7 月 25 日。 ↩ ↩2